

400-820-8531
 图1. 因为质谱的球氨基酸组学概况(图源:Shuken, J Proteome Res, 2023)
01.统计资料了解:多肽监定
一次LC-MS/MS自动运行生产的原有大资料集就是一款大的光谱仪仪真子集,所有光谱仪仪都会调取时、m/z值、效果和元大资料。用于MaxQuant或Proteome Discoverer(Thermo Fisher Scientific)等图片软件包治理 等大资料,添加肽和/或淀粉酶质目录,所有自动识别都会一款中考分数。很部分非靶向药物的自下而上的DDA淀粉酶质组学调查中施用的最经典型的肽鉴别方法步骤为大资料库归类(图2)。
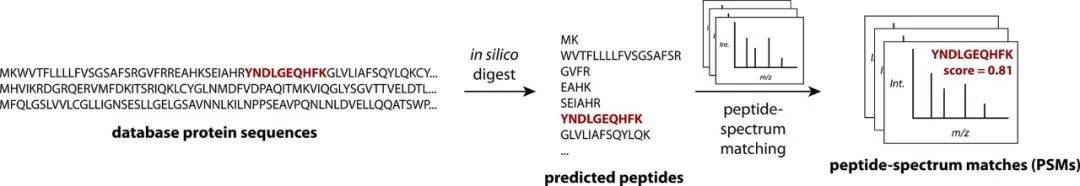 图2. 统计数据库显示关注的简易概要(图源:Shuken, J Proteome Res, 2023)
 图3. 小鼠Hexokinase-1的酪氨酸队列(图源:Shuken, J Proteome Res, 2023)
 图4. 场面描写m/z值、带引用的MS2谱,和图3中表现展示的场面描写编码序列(NILIDFTK)
1.1 数据显示库搜索网页计算方式实例:SEQUEST的创新分析
SEQUEST是199历经四年出版发行的第同一个全自動肽识别系统軟件。图5操作部骤了SEQUEST算法为基础的变得简化的概念。关键在于,对参考资料球胆固醇组分折的肽参与过滤器器,并能只充分考虑与破乳的碎裂亚铁铝离子的m/z值相近的前体(即电荷量的状态非特异朋友肽亚铁铝离子),然而绘制基础说法光谱仪图分析仪仪仪分析图仪分析仪(图5,最上层)。在将科学试验光谱仪图分析仪仪仪分析图仪分析仪与分折场面描写的m/z值参与初略是比较,基础说法光谱仪图分析仪仪仪分析图仪分析仪被更快过滤器器,匹配好场面描写的总数、MS2难度和其他一些相关联特证女子组自动合成同一个高考中考分数,仅调取来源于该高考中考分数的前500个基础说法光谱仪图分析仪仪仪分析图仪分析仪(图5,部骤1)。在避免前体峰,将光谱仪图分析仪仪仪分析图仪分析仪分为为三个想同的区内,并将一个区内的难度归一变为想同的值来调低科学试验光谱仪图分析仪仪仪分析图仪分析仪(图5,部骤2),这十步使科学试验光谱仪图分析仪仪仪分析图仪分析仪更表示基础说法光谱仪图分析仪仪仪分析图仪分析仪,以减少了创建基础说法光谱仪图分析仪仪仪分析图仪分析仪时忘记的可调觉醒石化质量的。在将一个m/z值处的难度相乘并将乘积一起,计算公式科学试验光谱仪图分析仪仪仪分析图仪分析仪与一个基础说法光谱仪图分析仪仪仪分析图仪分析仪直接的互不直接关系(图5,部骤3)。
 图5. 简单化了原SEQUEST数据显示库搜到算法流程图的计划书(图源:Shuken, J Proteome Res, 2023)
1.2 肽签别中的FDR掌控
我们都如何快速定一些成绩排名充足的高来说真实可靠的ID?日前到止,最流行时尚的的方法是 Target-decoy归类(图6)。该流程设定全部内部错误代码发现率(FDR),即被承受的PSM内部错误代码的均匀比重。是为了在设定FDR的互相最主要底限地判断真肽,是可以选用归类成绩排名和PSM的其他的显著特点的曲线搭配组合成(图6)。曲线搭配组合成中选用的因子{a, b,…}被调优以最主要底限地判断真肽,一般是选用percolator选用的机子借鉴改进算法。在这样的调优做完后,各种可超过所需要FDR相当于域值的关键适配(诸如,1%)被留存。这些过滤水数据统计集的FDR被视为“全部”FDR。
 图6. Target-decoy搜索引擎。PSM=肽谱搭配;FDR =内部错误察觉率(图源:Shuken, J Proteome
02.肽段一定量
有效率液质色谱在全正常运行工作中连续式地将多肽喷雾的角度到质谱仪中。4个扫描仪扫描时间段一遍,一般性都要3 s或较少,光谱分析图仪制造MS1光谱分析图;对此,在有效率液质离子交换柱冲洗掉工作中,前体的MS1峰时不时被观察动物到一次,这种MS1数据信息点一同导致色谱峰(图7A)。给定特殊的肽,其色谱峰的共同点,与其高强度或斜率接下积(AUC),适用于预估肽的相较丰度,这被称做非标准记化学发光法(LFQ),该方法步骤适用于有差异仿品中的数量统计较。 想要的提升一降钙素原检测显现性、试样通量和/或数据源齐全性,tag标签设计制剂就也可以利用于一降钙素原检测一致质谱中的俩个动物制品试样。在这种工艺中,除了英语不一样的拉曼光谱仪造成的肽或其电影精彩片段的m/z值不一样外,肽被tag标签设计为同等的氧分子群,与此同时永久保存动物学属性,如永久保存耗时、电离性和电影精彩片段模式切换。在基础代谢tag标签设计工艺中,如组织细胞培育酪氨酸安全稳定拉曼光谱仪tag标签设计(SILAC),采取动物制品系统将包含重拉曼光谱仪的酪氨酸tag标签设计整个的蛋清质组。在试样制作展开时,将先天“轻”蛋清与重蛋清搭配,接着与MS1光谱仪开始对比(图7B)。在等压法(即的品质一模一样,因不一样的tag标签设计极具同等的总的品质)tag标签设计工艺中,如并联的品质tag标签设计(TMT),肽段在消化系统后被tag标签设计,接着在LC-MS/MS前整合。低能CID(HCD)为每一家动物制品试样增加不一样的通知单范文阳铝离子;利用MS2或MS3复印机扫描侧量通知单范文阳铝离子屈服强度,就也可以进行深入分析一下判断出对于丰度(图7C)。利用LFQ,每晚启动进行深入分析一下个动物制品范例;利用SILAC,每晚启动常常进行深入分析一下两到这三个动物制品范例;利用TMT,以此就也可以进行深入分析一下多至18种不一样的动物制品范例。
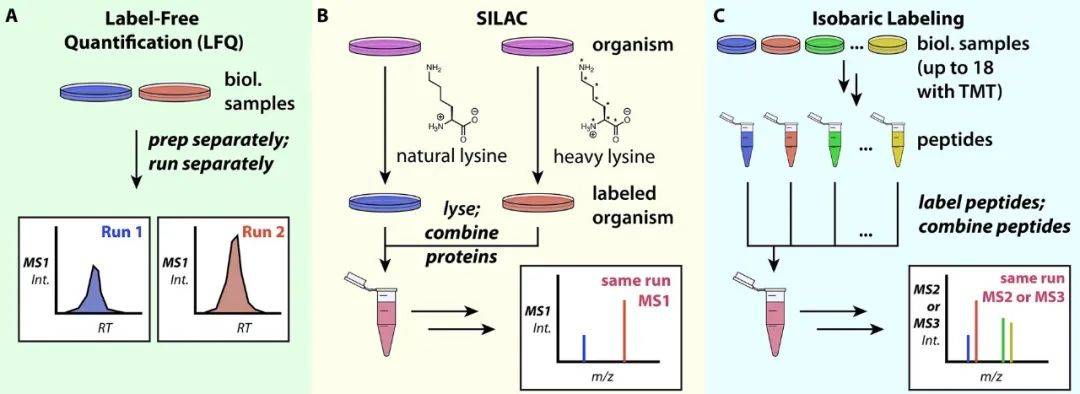 图7. 多肽一酶联免疫法的方式。A.在MS1的水平确定非标准件记一酶联免疫法;B. 细胞膜培训中酪氨酸相对稳定放射性同位素标出(SILAC);C. 等压标出
03.“球营养物质水平面”:判断球营养物质的性质和丰度
3.1 血清质测算与分组名
就算那些动用自下而上蛋清质组学谈到了“蛋清质”的个人身份和个数,但这句话一般是是签别和/或确立蛋清质群,其根源的蛋清质或什么是基因很有可能是不确立的。相对这偏误,最喜欢见的完成方案怎么写是动用每种PSM对于样品英文中存有相关的蛋清质的凭证。一旦每组蛋清质内有问题的凭证(即蛋清质队列与同每组签别的肽队列筛选,右图8中的蛋清质V和VI),则将这种蛋清质团体为一名蛋清质组(PG)。一旦一名蛋清质的筛选肽是另一个说的是名蛋清质的子集,则该蛋清质一般是被在排除在报告范文外面,而由于缺乏该蛋清质特别肽但其肽并非是子集的蛋清质统称可蕴含蛋清质。
 图8. 核高蛋白推断出和组群攻略(图源:Shuken, J Proteome Res, 2023)
3.2 球蛋白关卡FDR抑制
大都数执行命令蛋清质分成小组的留行系统包,如MaxQuant和Proteome Discoverer,也都是可以统计蛋清质平均技术监定FDR的相信,并将其简单调正到能接受的平均技术。有多个方法步骤都是可以管理蛋清质平均技术的FDR。那种简单的营销策略是用耳料PGs,即完全性由耳料PSM組成的PG,她们被自动的抹去并因为与制定要求PSM一模一样的蛋清质分析判断阶段。为每隔制定要求和耳料PG倡导一两个分数线,同意以与PSM FDR类似于的手段管理蛋清质平均技术FDR(图6)。3.3蛋白质组定量分析
多肽和核核蛋白酶酶酶质真正的爱情的联系的几现象方面使这样进程繁琐化。PG内的肽也许在二者适合的核核蛋白酶酶酶质中真正的爱情有所区别,这也许会印象到二者的丰度(图8)。假如PG中的肽是该PG所独立空间拥有的,它是有促进的,充许对单一核核蛋白酶酶酶质展开量化分析。不过,繁琐的是肽也许造成于包含有译文资料后突显的核核蛋白酶酶酶质,其丰度印象到肽的的力度,再者,致使DDA之前的随即性,一下肽也许在是一个土样中查看到而在另是一个土样中查看找不到。常用的统计资料治疗app电脑软件包为用户账户带来了理解决以上现象的按钮。基本上都数app电脑软件(涉及MaxQuant)只充许对PG-unique肽展开参考值。一下(如Spectronaut ,Biognosys)充许更多的尺寸,如受限制参考值到核核蛋白酶酶酶质特异形肽,或选用可否适用肽的力度的中六五位数、和、数学算起均匀值或几何体均匀值来算起PG的数量。对於LFQ,可以要注意的是MaxQuant中进行的常用的MaxLFQ图像匹配。当在有所区别的样板中识别系统出有所区别的前体集时,MaxLFQ用采用了用于的两两更和适用中六五位数百分率来更PG来治疗低下值。等压标上和统计资料独立空间搜集(DIA)是才能减少或排除低下值的两种工艺。3.4 计算数据分析和菌物学讲解
若是算出出PG的对应占比,表明实验英文性的生命科学学形态,能操作很多器具对最终去动态数据报告汇总研究和表述。Perseus和MSStats是的设计应用在营养素质组占比治理和动态数据报告汇总研究的时髦软件下载包。动态数据报告也能操作java开发文学语言(如python或R)自功研究。在通常情况下较好营养素质组学实验英文性中,涉及到从列表页中祛除水污渍或鱼饵,操作对数计算使占比相近正态动态数据分布,将动态数据报告归一化以处理工作间的技巧遗传变异性,操作动态数据报告汇总质量定期检查(如t质量定期检查/方差研究/平滑再现)质量定期检查转变,并对最终p值去多猜测质量定期检查。 统计表分享做完后,可是能够对其进行怪物学解答一下。Gene Ontology是进行具体研究分析在测试英文中造成变换的怪物有效途径的某个潮流数剧库。STRING出具了关干感爱好的淀粉酶质之前知道有关或上下级反应的的信息。对应分享,如权重dna对应wifi在线分享(WGCNA),利用测试英文中淀粉酶质丰度发生变化的类似于层次营造淀粉酶质wifi在线,这能够进十步认识测试英文中淀粉酶质之前的有关。利用基础性解答一下这部分分享的可是,怪物学如果能够实现适配或回应,因此能够制造新的如果。04.拜谱动物分析:质谱工做的流程
整体来说就,料框记的自下而上的事业标准流程下面: (1)分离处理结构/草木、溶解完神经元;用尿素溶液和/或去垢剂使淀粉酶质转化。 (2)用DTT或TCEP等技巧下降二硫化橡胶物;用IAA烷基化半胱氨酸。 (3)用冷二甲苯、氯仿-甲醇沉定法或磁珠沉定法地方纯化蛋白酶质(一些工做过程不实用有影响的去垢剂如SDS,可绕过这一个步骤)。 (4)用胰蛋白酶酶质酶或LysC结合蛋白酶酶质酶转化蛋白酶酶质质。 (5)用C18包被的油烟净化器吸管头离心分离力洗涤/脱盐多肽;用高压气离心分离力机等蒸馏石油醚。 (6)将肽重悬于LC-MS兼容的容剂中,这类0.1%甲酸水氢氧化钠溶液;主要包括合理的设备手段做出LC-MS/MS具体分析;在运作成功完成后文献检索原史统计数据。 (7)食用靠谱的游戏包工作原创数据表格信息,如MaxQuant或Proteome Discoverer,或游戏包的组成,施行数据表格信息库搜索引擎、FDR把控、相比定量分析和血清质判定。 (8)运行和程序编写语文(如python或R)或软件下载包(如Perseus或MSStats)强制执行数据统打探讨探讨。 (9)会根据实验设计的动物学关键技术来解悉最终结果;这可不可以能够 线路或互联网级研究分析网络资源(如Gene Ontology、STRING或WGCNA)来铺助。 05领先题目
也可以DDA做的非靶向疗法药物自下而上的无标上淀粉酶质组,也有更加的源于质谱的最简单的技术来论述淀粉酶质组(图9)。测量仪器和算法流程图均在推陈出新的的更新,齐全淀粉酶质、底向上和大自然质谱法也用作介绍低更复杂的特征的子样本;淀粉酶的译员后掩盖因为本身至关首要的干预功用得到茫茫的论述天下。框架的淀粉酶质组学、化工淀粉酶质组学和贴近标上等的技术运用化工、酶或热的技术来侦测淀粉酶质,为论述淀粉酶质框架的、化工、定位手机、淀粉酶质-配体主动功用或淀粉酶质-淀粉酶质主动功用开发了许多的有机会。优于DDA,数据报告统计文件独立性采样(DIA)都是种愈来愈越受追捧辞的采样最简单的技术,最兴起的DIA最简单的技术是源于SWATH-MS,进来整体MS1规模内的大部分m/z值在每台扫锚频次内都构成在勾玉中,这小臭加快了数据报告统计文件齐全性,增长了淀粉酶质组学深度1。在靶向疗法药物淀粉酶质组学中,其中一种某一的淀粉酶质或三组淀粉酶质被用于介绍的个人阶段梦想,其个人阶段梦想是狠抓总是 最简单的技术执行时都能监测到个人阶段梦想淀粉酶质(数据报告统计文件齐全性强),较大 容许地加快流畅度和信息规模,或者一定量精确度性和精细度。 面对大数量的核膳食纤维签定和酶联免疫法,质谱法是近几年最时髦的方式方法,在未来生活,质谱与多种非质谱技巧的构建使用的就可以深一点入地熟知整微生理学中的核膳食纤维组。
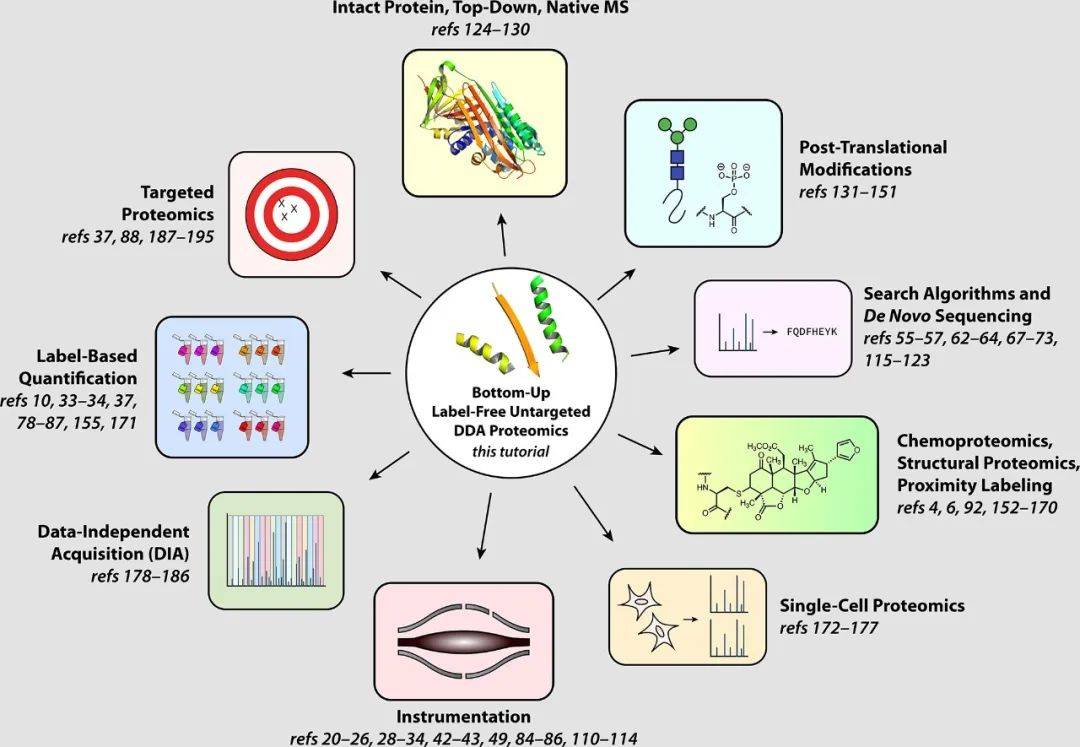 图9. 根据质谱的血清质组学的子领域行业(图源:Shuken, J Proteome Res, 2023)
关联性学术论文:
Shuken SR. An Introduction to Mass Spectrometry-Based Proteomics. J Proteome Res. 2023; 22(7):2151-2171. doi: 10.1021/acs.jproteome.2c00838.


 留意民众号


 留意和聚美优品


